모델 비교
GPT-6 vs GPT-5.6: 실제 업무에서 Astra와 Sol 선택하기
가장 어려운 다단계 작업에는 GPT-6 Astra가 더 강력한 후보지만 지연, 접근성, 비용이 더 중요하면 GPT-5.6 Sol이 실용적인 기본값입니다. OpenAI 결과에서 큰 개선은 컴퓨터 조작, 자동화, 긴 컨텍스트 검색, 과학과 사이버 보안에 집중됩니다. 모든 프롬프트의 이점이 같지는 않습니다.
모델 번호보다 합격 작업의 경제성을 보세요. GPT-5.6이 이미 정확하고 빠르고 저렴하게 처리하는 일은 옮겨도 비용만 늘 수 있습니다. 도구 조율, 복잡한 추론, 긴 자료나 전문 산출물에서 반복적으로 실패한다면 Astra를 통제된 조건에서 평가할 가치가 있습니다.
출처: GPT-6 발표; 모델 사양; 개발자 가이드; 안전성 개요; Artificial Analysis의 Astra; GPT-5.6 Sol 비교; API 디버깅 시험; 실무 기반 코딩 비교. 2026년 9월 7일 확인.
빠른 비교
| 선택 요소 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| 적합한 작업 | 처음부터 끝까지 복잡한 업무 | 낮은 운영비로 폭넓은 일반 업무 |
| 컨텍스트 창 | 1,050,000토큰 | 사용하는 변형의 최신 사양 확인 |
| 최대 출력 | 128,000토큰 | 사용하는 변형의 최신 사양 확인 |
| 추론 강도 | Low~max, none 없음 | 제품별 옵션을 포함한 다양한 설정 |
| 새로운 기능 | 비동기 도구, 턴 도중 지시, 대화 중 추론 변경 | 기존 도구 및 Responses API 흐름 |
| Standard API 입력 | 100만 토큰당 10달러 | 더 낮음. 현재 요금 확인 |
| Standard API 출력 | 100만 토큰당 50달러 | 더 낮음. 현재 요금 확인 |
| 접근성 | 단계적 제공, 무료 API 계층 없음 | 해당 OpenAI 제품에서 더 널리 이용 |
| 독립 지능 점수 | max에서 55 | max에서 51 |
| 독립 실측 출력 속도 | max에서 초당 64.3토큰 | max에서 약 초당 76토큰 |
| 독립 지수 과제당 비용 | max에서 2.57달러 | max에서 1.25달러 |
| 운영 방침 | 고가치 어려운 일부터 배정 | 일반·혼합 업무의 기준으로 유지 |
독립 값은 Artificial Analysis의 시점 자료이며 공급자와 테스트 업데이트에 따라 바뀝니다. 일반 지능은 소폭 상승하고 출력은 느리며 과제 비용은 약 두 배라는 결과이지, 모든 분야의 세대 도약을 증명하지는 않습니다. 구매 계산은 최신 사양으로 하세요.
독립 시험과 출시 설명
Claire Vo의 사전 사용기는 Sol과 Fable로 어려웠던 ChatPRD 기능의 진전을 설명합니다. 막혔던 일에 Astra를 시험할 이유는 되지만 선택된 성공으로 일반적인 향상 폭은 알 수 없습니다. 같은 작업, 저장소 상태와 수락 기준을 유지해 비교하세요.
Matt Shumer의 평가는 일상 개발에는 Astra, 시각 작업에는 Claude를 선호합니다. 좋은 소통과 감독 감소가 생성 속도보다 중요하면 비싼 모델도 기본값이 될 수 있음을 보여 줍니다. 다만 개인 평가이며 통제된 Astra-Sol 시험은 아닙니다.
따라서 이 글의 권고는 예산을 관리하는 팀 대상입니다. 작동하는 기준 모델을 유지하고 현재 개입이 가장 많은 사례부터 시험하세요. 업무가 다른 개인은 합리적으로 다른 결정을 내릴 수 있습니다.
OpenAI의 큰 개선은 에이전트, 컴퓨터 조작, 긴 컨텍스트 평가에 나타납니다. Artificial Analysis의 일반 결과는 더 제한적입니다. Astra max 55점, Sol max 51점입니다. Astra 출력량은 추적 대상 중앙값보다 적지만 Sol보다 출력 속도가 느리고 max의 첫 토큰 대기도 깁니다.
한 실제 API 디버깅 시험에서는 Astra와 세 GPT-5.6 변형이 같은 문제를 진단했습니다. Astra가 가장 좋은 주의점과 확인 계획을 제시했지만 시간은 약 두 배, 비용은 약 네 배였습니다. 빠진 주의점이 값비싼 오류를 낳을 때는 유리하지만 명령이나 원인 후보만 찾을 때는 그렇지 않습니다.
별도의 실무 기반 코딩 시험은 Sol이 아닌 GPT-5.6 Terra와 비교했습니다. 둘 다 기존 테스트를 통과했지만 Terra는 관련 페이지 상태를 깨뜨렸고 Astra는 보존하고 테스트를 추가했습니다. 필자는 밀접한 다영역 작업은 Astra로, 일반·기계적 변경은 저렴한 모델로 배정하도록 바꿨습니다. 모든 모델을 교체하는 것보다 근거 있는 방식입니다.
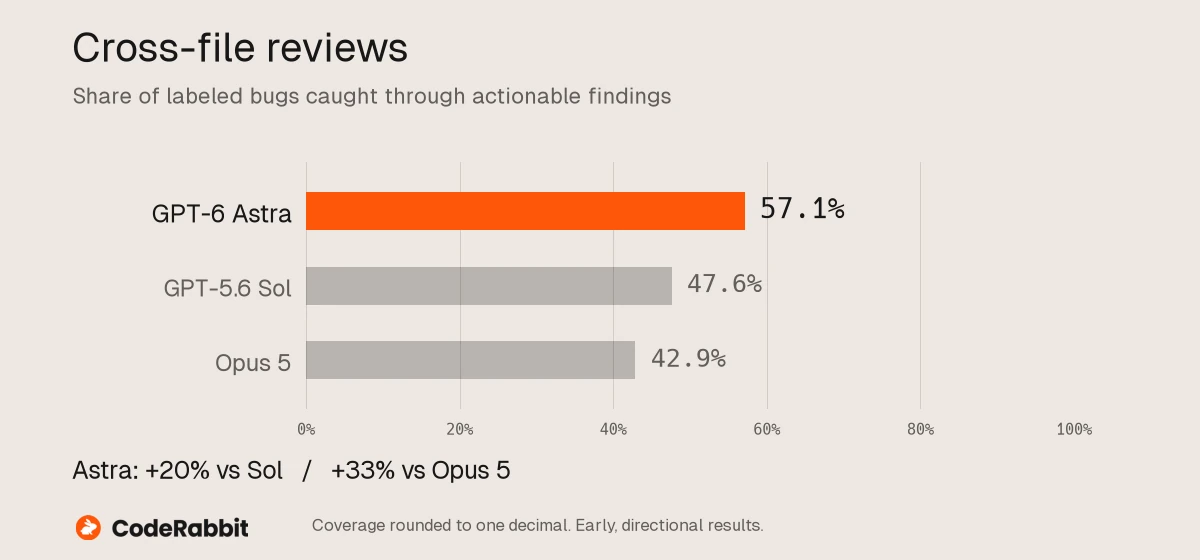
CodeRabbit가 공개한 파일 간 리뷰 결과입니다. 초기 평가이며 전체 리뷰 품질을 뜻하지는 않습니다.
GPT-6의 개선이 뚜렷한 분야
OpenAI 출시 평가는 같은 기관이 두 모델을 시험하므로 비교에 유용합니다. 하지만 일부는 내부 시험이며 추론 수준 중 최고 점수를 사용하고, 운영 환경의 시스템 지시와 도구가 결과를 바꿀 수 있습니다.
| 평가 | GPT-6 Astra | GPT-5.6 Sol | 시사점 |
|---|---|---|---|
| OSWorld 2.0 오프라인 | 72.6% | 65.7% | 데스크톱 환경 조작 개선 |
| AutomationBench | 41.4% | 18.1% | 다단계 자동화에서 큰 향상 |
| Terminal-Bench 4.0 | 57.9% | 37.3% | 터미널 개발 작업 개선 |
| 내부 DB 이전 과제 | 63.9% | 42.7% | 상태가 있는 긴 코드 변경에 잠재력 |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 고급 수학 추론 강화 |
| MRCR v2, 512K~1M | 96.3% | 73.8% | 매우 긴 자료에서 검색 개선 |
| ARC-AGI-3 | 99.9% | 7.8% | 새로운 상호작용 과제의 큰 향상 보고 |
Astra가 모든 경쟁 모델을 모든 공개 시험에서 압도하지는 않습니다. DataCamp 해설은 도구가 있는 Humanity's Last Exam에서 Claude Fable 5.1에 뒤지고, ARC-AGI-3의 99.9%가 상태를 유지하는 공급자 어댑터 실행 환경에 의존한다고 지적합니다. 무상태 API 호출이 같은 점수를 낼 것이라 기대하지 마세요. 배포를 결정하기보다 무엇을 시험할지 고르는 자료입니다.
컴퓨터 조작과 에이전트 업무
GPT-6를 시험할 가장 강한 이유입니다. 코드, 브라우저, 문서, 스프레드시트, 발표 자료와 전문 프로그램을 오가도록 설계됐습니다. 비동기 호출은 느린 도구 중에도 독립 추론을 가능하게 하며, 턴 도중 지시는 긴 세션을 재시작 없이 수정합니다.
Sol도 도구와 에이전트 업무를 지원합니다. 과정이 짧고 권한이 좁으며 합격 기준을 충족하면 유지하세요. 진행을 잃거나 새 지시를 잘못 처리하거나 여러 프로그램에서 막히거나 재시도가 많다면 Astra를 시험합니다.
더 강한 모델도 주변 설계를 없애지 않습니다. 인증, 도구 스키마, 권한, 상태, 감사, 승인과 롤백은 앱의 책임입니다. AI 에이전트 아키텍처에서 이 경계를 설명합니다.
컨텍스트와 기억은 다릅니다
Astra의 105만 토큰 창은 큰 자료 묶음을 담지만 요청의 일시적 용량입니다. 고객, 프로젝트, 정책에 대한 영속적이고 정확한 기억이 저절로 생기지는 않습니다. 장기 기억에는 출처 ID, 갱신 규칙, 충돌 해결, 삭제, 접근 제어와 사용자 가시성이 필요합니다.
함께 검토할 제한된 자료에는 긴 컨텍스트, 더 크고 변하는 자료에는 검색, 실행 간 보존할 결정과 승인된 결과에는 영속 프로젝트 상태를 사용하세요. AI 지식 관리 가이드는 생성 요약을 정본으로 삼지 않고 출처를 보존하는 법을 설명합니다.
토큰보다 완료한 업무의 비용을 비교하세요
Standard API는 입력 100만당 10달러, 출력 100만당 50달러입니다. 입력 272,000토큰 초과 요청은 전체에 높은 단가가 적용됩니다. 캐시, 도구, Fast, Batch, Flex에는 별도 요금이 있습니다.
토큰, 반복 시도나 사람 검토가 줄면 어려운 일은 Astra가 총액상 저렴할 수 있습니다. 반대로 대량 분류가 고급 추론으로 얻는 이점이 없으면 완벽한 답도 비경제적일 수 있습니다.
디버깅 실측은 Astra 약 0.194달러·75.5초, Sol 약 0.048달러·39.3초로 차이를 보여 줍니다. 핵심 진단은 같고 Astra의 가치는 정확한 한계와 검증 계획이었습니다. 단일 프롬프트로 평균을 정할 수는 없지만 효율 주장에 균형을 줍니다.
다음처럼 계산합니다.
합격 작업 비용 =
  모델 입력 + 모델 출력 + 캐시 + 도구 호출
  + 실패한 시도 + 검토 시간 + 수정 작업

이전 가치 =
  방지한 오류 + 절약한 노동 + 단축한 주기
  - 합격 작업당 추가 비용
두 모델을 같은 입력으로 측정합니다. 검토 시간을 0으로 잡지 마세요. 가장 큰 숨은 비용인 경우가 많습니다.
안전성과 제어
OpenAI는 Astra가 Sol보다 탈옥, 프롬프트 인젝션, 범위 외 행동에 강하다고 설명합니다. 54,000개 이상의 Codex 작업을 쓴 내부 모의시험에서 심각한 비정렬 행동 경고는 약 절반이었습니다. 동시에 서면 추론의 감시 가능성은 떨어졌다고 보고합니다.
TechRadar가 인터뷰한 전문가는 추론 문장에 의존하기보다 관측 가능한 행동을 감시하고 중간에 멈출 수 있어야 한다고 봅니다. 초기 커뮤니티 보고에도 일반 코드 작업이 오래 실행된 뒤 보안 분류로 차단된 사례가 있습니다. 개인 사례지만 OpenAI도 정상 업무 중단 가능성을 안내합니다. 오탐 중단과 잃은 시간을 비교에 넣으세요.
다음 방식으로 평가합니다.
- 추론이 안심되는지보다 실제 행동과 결과를 시험합니다.
- 각 도구에 좁은 스키마와 명확한 권한을 줍니다.
- 공격적 자료와 불가능한 과제를 추가합니다.
- 전송, 삭제, 구매, 게시, 접근 변경에 확인을 요구합니다.
- 입력, 호출, 승인, 출력, 검토 결정을 독립 기록합니다.
어느 모델에든 쓰기 권한을 주기 전 AI 에이전트 보안 체크리스트를 사용하세요.
어떤 모델을 선택할까요?
Astra가 적합한 경우
- 보통 여러 번 시도하거나 사람이 이어받아야 할 정도로 복잡합니다.
- 컴퓨터 조작이나 여러 도구의 조율이 핵심입니다.
- 자료가 매우 길고 검색 누락 비용이 큽니다.
- 고가치 문서, 분석, 발표 자료나 코드 변경이 결과물입니다.
- 자체 평가에서 합격 결과의 측정 가능한 향상이 보입니다.
Sol을 유지할 경우
- 현재 과정이 품질과 신뢰성 목표를 충족합니다.
- 응답 속도나 대량 처리 경제성이 중요합니다.
- 짧고 반복적이며 구조적이거나 검증하기 쉽습니다.
- GPT-6의 접근성이나 속도 제한이 서비스 요구에 맞지 않습니다.
- 팀에 평가와 검토 과정이 아직 없습니다.
두 모델로 나누는 경우
대부분의 시스템은 양자택일로 옮길 필요가 없습니다. 저렴한 기준 모델에서 시작해 자료량, 위험, 검증 실패, 도구 수, 요구 품질 같은 관측 신호로 상향합니다. 배정 규칙은 감사하기 쉽게 유지하세요.
나란히 비교하는 평가 템플릿
업무: [이름]
현재 모델: GPT-5.6 Sol
후보: GPT-6 Astra
사례: [20-50개 대표 작업]

항목별 0-2점:
- 정확한 사실과 계산
- 필수 제약 충족
- 완전하고 사용 가능한 결과
- 허용 범위 준수
- 출처와 불확실성 표시

별도 기록:
- 실제 소요 시간
- 입력/출력/캐시/도구 비용
- 재시도와 실패
- 검토 시간(분)과 수정

도입 조건:
- 중대한 안전 또는 범위 퇴행 없음
- 품질 향상이 통계적·실무적으로 유의미
- 합격 작업 비용이 예상 규모에 적합
실용적인 도입 순서
- 대표 운영 입력과 수락 조건을 고정합니다.
- 동등한 도구·권한으로 두 모델을 실행합니다.
- 가능하면 검토자에게 모델명을 숨깁니다.
- 평균만 보지 말고 실패를 확인합니다.
- 대상 업무 일부만 Astra에 배정합니다.
- 비용, 수정, 사고, 사용자 개입을 추적합니다.
- 지속적으로 가치 있는 영역만 확대합니다.
Ottermind는 원자료, 비교 출력, 검토 결정과 최종 결과를 한 프로젝트에 모을 수 있습니다. 분리된 대화 화면을 모으기보다 AI 에이전트 워크스페이스에서 전체 업무를 평가하세요.
자주 묻는 질문
Astra가 항상 Sol보다 좋은가요?
아닙니다. 여러 평가에서 강하지만 Sol이 더 빠르고 저렴하고 접근하기 쉬우며 일상 업무에 충분할 수 있습니다.
높은 API 가격을 지불할 가치가 있나요?
어려운 일의 재시도, 검토나 실패를 줄이면 그럴 수 있습니다. 도구와 사람의 작업도 합격 비용에 포함하세요.
GPT-6가 GPT-5.6을 대체하나요?
자동으로 대체하지 않습니다. OpenAI는 계속 GPT-5.6을 제공합니다. 일상은 GPT-5.6, 가장 어려운 사례는 GPT-6로 나누는 구성이 가능합니다.
코딩에는 어느 쪽이 좋나요?
OpenAI는 Terminal-Bench 4.0 등에서 Astra의 높은 점수와 특히 내부 DB 이전의 큰 개선을 보고합니다. 자체 저장소, 지시, CI 조건에서 둘 다 시험하세요.
긴 문서에는요?
Astra는 105만 컨텍스트와 OpenAI가 보고한 향상된 검색을 제공합니다. 문서 선택, 인용, 충돌 처리와 사람 검토는 여전히 필요합니다.
같은 프롬프트로 옮겨도 되나요?
공정한 기준을 위해 같은 작업 계약으로 시작하고 실패를 확인한 뒤 조정합니다. GPT-6 API 가이드에 이전 목록이 있습니다.
