技術ガイド
GPT-6のコード評価:ファイル間の不具合、小修正、実測結果
GPT-6 Astraのコード能力で注目すべきなのは、コードベース内の分散情報を結び付ける力です。初期試験では、単純な修正より難しいファイル横断レビューで効果が大きくなっています。変更の影響を調査する候補として有力ですが、日常実装では費用と速度も比較すべきです。
CodeRabbitは指摘が既知の不具合を捉えるかを測り、Real Pythonは5つの固定プロンプトで振る舞いを見ます。異なる問いを扱う2つの外部評価を合わせると、単一ランキングより実用的な出発点になります。
出典: CodeRabbitの評価; Real Pythonの試験; OpusBoosterの比較。2026年9月7日確認。結果や体験は本文で各著者に帰属させています。
CodeRabbitの測定内容
9月4日の評価で、CodeRabbitは対処可能な指摘による不具合の検出率を次のように報告しています。
| 評価対象 | Astra | Sol | 差 |
|---|---|---|---|
| 全体 | 61.3% | 59.0% | 2.3パーセントポイント |
| 難しいファイル横断の部分集合 | 57.1% | 47.6% | 9.5パーセントポイント |
難しい対象での約20%の相対改善は、20ポイントの上昇ではありません。各チームが出荷する不具合が20%減る意味でもありません。この評価で特定した欠陥を測ったもので、2行は難易度の分布が異なります。
影響がファイル間に広がる変更でAstraを試す理由にはなりますが、全コメントの正確性、すべての重要不具合の発見、小変更に最も高いモデルが必要ということは証明しません。
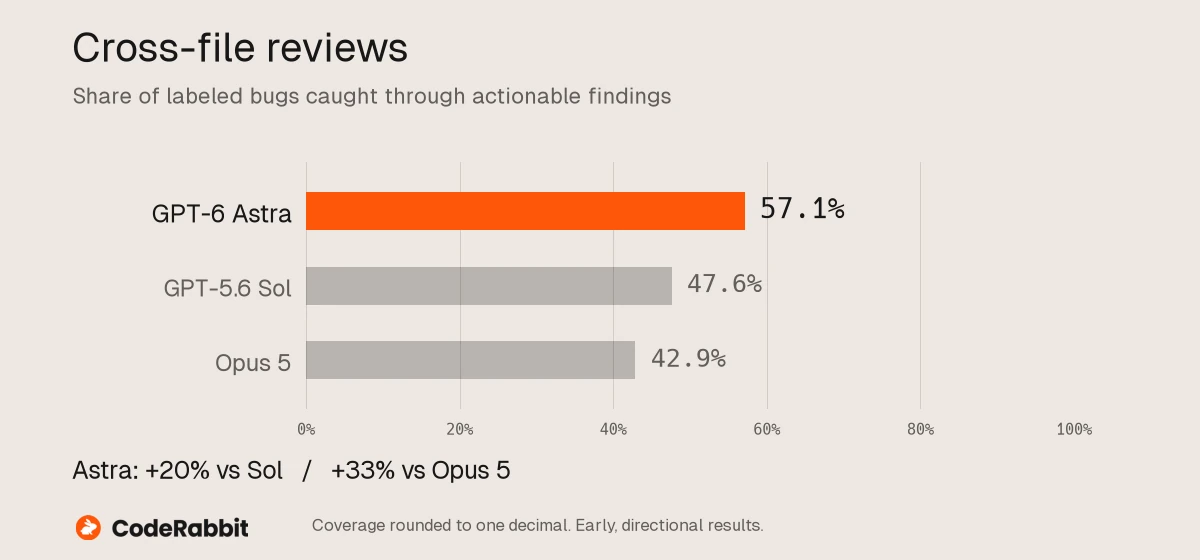
CodeRabbitが公開したファイル横断レビューの結果です。初期評価であり、レビュー品質全体の指標ではありません。
Real Pythonの試験内容
5つの固定プロンプト試験はOpenRouter経由、既定推論、各1回、システムプロンプトなしで行われました。出力は読者が確認できるよう公開されています。
モデルは架空の標準ライブラリー関数が存在しないことを見抜きました。小さなフラグ追加では最小7行に対し11行を変更し、5課題合計で0.31米ドルでした。コードが妥当そうだから採用するのではなく、架空API、変更量、実行を調べる方法として有用です。
5問でリポジトリ全体の性能は予測できません。ただし大きなベンチマークが見落とす細かな行動を明らかにできます。
テスト合格でも機能を見落とす理由
実際の製品課題に基づくAstraとTerraの比較では、どちらも既存テストを通過したものの、一方が連動するページング状態を誤処理しました。Astraは関係を保存し、対応テストを追加しています。
重要なのは、依頼が変える機能契約を確認することです。新機能の価値となる操作を、既存テストが一度も試していないかもしれません。新しい関数だけでなく、利用者の経路を検証しているかを問いましょう。
点数の裏にあるパッチを見る
Real Pythonは行数と小修正の差分を公開しています。追加行には引数定義の書式もあるため、最小行数を超えただけで有害な過剰設計とは言えません。依頼外の動作を変えたかが重要です。確認時点では実務利用の続編は未完成なので、固定5問はその証拠だけで評価します。試験とパッチを参照。
どのコードエージェントでも同じ区別が必要です。長い変更は明確さを増し、短い変更は互換性破壊を隠すことがあります。追加コードの作用、変えた既存動作、修正なしでは新テストが失敗するかを確認します。
ベンチマークで候補を選び、実物を見てリポジトリへの適合を決めます。製品デモ、不具合検出率、固定プロンプトはそれぞれ違う問いへの答えです。
実例形式:共有ページングの変更をレビュー
独立した2つのページング付きリストを考えます。利用者が1つ目を3ページ目にし、2つ目を次へ進めた場合、1つ目は3ページ目のままであるべきです。個々のページングは正常でも、組み合わせが壊れることがあります。
URL生成、クエリ解析、コンポーネント状態、ブラウザー遷移を追います。新リンクに2つ目のパラメーターしかなければ、1つ目の選択が消えるかもしれません。片方だけの単体テストでは見つからない可能性があります。
開始URL:/results?customersPage=3&invoicesPage=1
操作:請求書を2ページ目へ進める
期待:/results?customersPage=3&invoicesPage=2
追加確認:再読み込み、戻る操作、不正なページ値
OpusBoosterの例が調査の価値を示すのは、こうした関係です。実装前に受け入れ例を書く大切さも分かります。エージェントとレビュー担当者に目標を示しつつ、既存の補助関数を使う余地を残せます。
検出率とレビュー品質を分ける
既知の不具合を多く拾っても、誤検出で注意を奪う可能性があります。担当者が採用・却下した指摘と、それぞれの確認時間を記録します。発生条件のない漠然とした懸念は、省く以上の労力を消費しかねません。
| レビュー結果 | 記録 | 目的 |
|---|---|---|
| 確認済み欠陥 | 再現と影響する動作 | 有用な指摘の証拠 |
| 誤った指摘 | コードが正しい理由 | ノイズを測る |
| 未解決の懸念 | 足りない証拠や環境 | 不確実性を不具合の断定にしない |
| 見逃した欠陥 | 過去の不具合や後の再現 | 検出範囲の不足を示す |
可能ならモデル名を伏せて担当者に判断してもらいます。小設定変更と複数サービス移行を説明のない平均点に混ぜず、難易度を見える形で保ちます。
影響確認に必要な情報を渡す
依頼と差分から始め、影響する呼び出し元やテストを読めるようにします。旧APIクライアント、保存済みデータ形式、スクリプトに解析される公開コマンドなど、忘れやすい互換要件も含めます。
無関係な資料を大量投入しないでください。影響経路を追い、何を読む必要があったか説明させます。確認しやすくなり、重要依存関係が一度も考慮されなかった場合も気付けます。
共有型なら生成側と利用側、DB移行なら更新と復旧の仮定、UIなら期待される状態遷移を確認します。AIエージェントの設計ガイドではコンテキストとツールの位置付けを説明します。
変更に合うテスト範囲にする
OpenAIの GPT-6プロンプトガイドは、小修正で必要以上の試験を実施する場合があると述べています。実行前に重点テスト、証明する動作、広い試験へ進む条件を定めます。
誤字修正と共有認証の変更では確認量が違います。小パッチで全テストを何度も回しても証拠はほぼ増えず、共有動作では単体テスト1つでは不足し得ます。影響動作に基づいて確認範囲を説明させましょう。
変更された動作を対象にしたテストから始めてください。
共有契約への影響、または重点試験が広い退行を示した場合に
確認範囲を広げてください。
各確認が証明する動作を報告してください。
実行できない場合はコマンドと理由を示してください。
無関係のアサーションを弱めてテストを合格させないようにします。削除された試験と変わった期待値もレビュー対象です。テストが本来の契約を表していて初めて、合格に意味があります。
受け入れ済み変更の費用を比較する
各ケースでモデル使用量、ツール時間、再試行、担当者レビューを記録し、合格パッチに到達する費用を比較します。安い初回が2回の修正後には高くなる場合も、高いモデルが不要な再設計に時間を使う場合もあります。
まず小規模に振り分けます。難しいファイル横断レビューをGPT-6、日常パッチを現行モデルへ回し、有効指摘の増加や修正減少が見えたら拡大します。レビューの勝利を実装、文書、視覚設計に無検証で広げてはいけません。
自分で試す4種類のケース
| ケース | 依頼 | 受け入れ確認 |
|---|---|---|
| 小変更 | 既存コマンドにオプション追加 | 未指定なら元出力を維持 |
| ファイル横断 | 共有データ項目を変える | すべての生成側・利用側が新契約に一致 |
| デバッグ | 再現可能な故障の調査 | 再現を解消し隣接動作を維持 |
| レビュー | 過去の不具合変更を見る | 憶測ノイズなく真の欠陥を特定 |
各候補にクリーンな開始状態を用意し、指示、ツール、予算を同じにします。パッチ、テスト変更、人の修正、受け入れまでの時間を残します。モデル比較は GPT-6とGPT-5.6を参照してください。
コードレビューのプロンプト
変更を意図した動作に照らしてレビューしてください:[目標]。
呼び出し元、データ利用側、エラー経路を追ってください。
各指摘に次を含めてください。
- 不具合を発生させる具体条件
- 影響動作と根拠となるファイル参照
- 問題を示す再現手順またはテスト
対処可能な欠陥を優先し、不確実性を明示してください。
レビュー中はファイルを変更しないでください。
実装のプロンプト
既存リポジトリの方法で[動作]を実装してください。
方針を決める前に関係コードとテストを読んでください。
[不変条件と互換要件]を守ってください。
重点試験に加え[具体的なユーザー経路]を確かめてください。
変更、検証結果、残る制限を返してください。
不変条件を具体化します。他方のフィルターを保持する、既存コマンド出力を維持する、公開レスポンスを変えない、といった条件は「本番品質のコード」より検証しやすくなります。
いつ移行が見合うか
複数モジュールを慎重に考える必要がある時やレビュー工数が大きい時に試します。反復的で簡単に確認できる仕事は安いモデルに残します。生成行数やコメント数は生産性ではありません。余計な変更は確認を増やします。
調査、要件、開発計画が混ざるプロジェクトでは、依頼と資料を Ottermind に整理します。コード検証はリポジトリ内で行い、結果をプロジェクト全体の判断につなげましょう。
よくある質問
GPT-6はコードレビューに強いですか?
CodeRabbitの初期評価では対処可能な検出が増え、難しいファイル横断で差が大きくなりました。自分のコードでも確認してください。
高得点ならレビューを省けますか?
いいえ。検出は不完全で、役立つ指摘も変更前に検証が必要です。
小パッチにも常にAstraが最適ですか?
公開データはそれを示していません。正しさ、不要変更、速度、費用を比べましょう。
合格テスト以外には何を測りますか?
機能契約、退行リスク、削除されたカバレッジ、人の修正、受け入れまでの時間です。
開発者は何から始めるべきですか?
上のケースを試し、統合の詳細は GPT-6 APIガイドを確認してください。
