Der Käuferführer
Beste KI-Überwachungs-Tools: Wie man Agenten und LLM-Workflows wählt
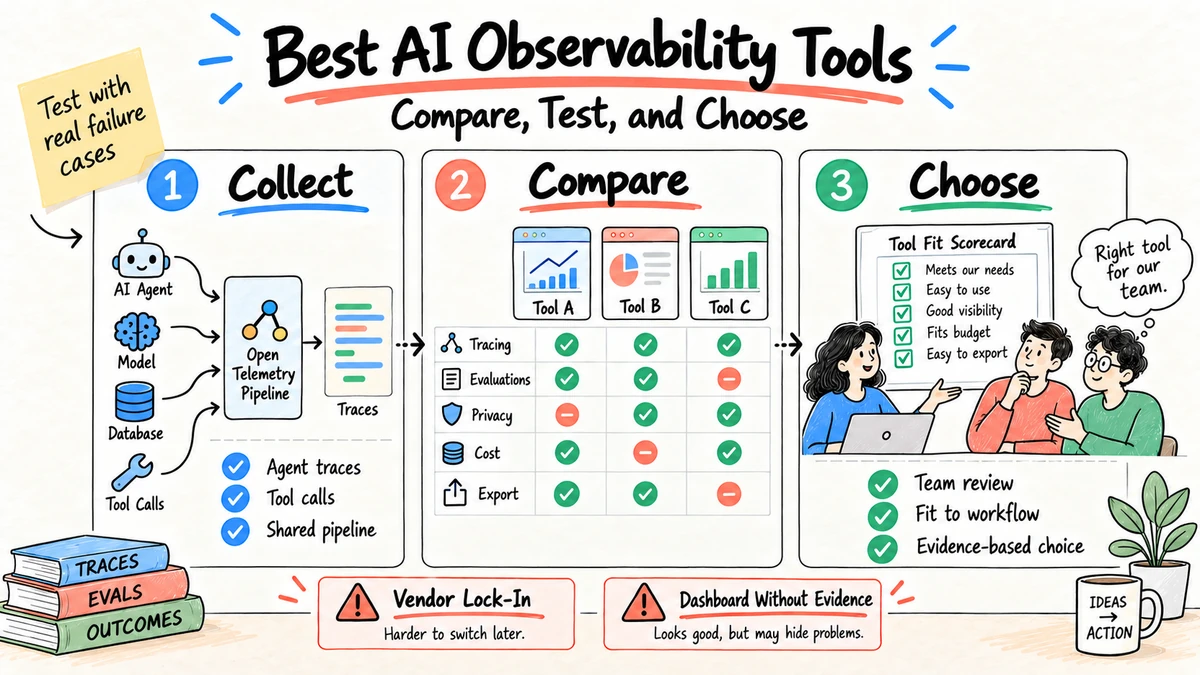
Das beste AI-Observierungswerkzeug ist das, das einen Produktionsfehler mit dem genauen Lauf, der Anlauf- oder Modellversion, dem Abrufresultat, dem Tool Call, der Bewertung und dem Benutzerergebnis verbindet. Wählen Sie aus den Anforderungen, nicht aus der längsten Feature-Liste. Die meisten Teams benötigen interoperable Spuren, Aufgaben-spezifische Bewertungen, Datenschutzkontrollen und einen Exportweg mehr als ein anderes generisches Dashboard.
Recherche und Transparenz: Dieser Käuferführer verwendet öffentliche Dokumentation aus OpenTelemetry, LangSmith, Arize Phoenix, Gehirnvertrauen, und Datadog, vom 4. September 2026 überprüft. Ottermind wird nicht als Anbieter von Beobachtungsmöglichkeiten eingestuft. Merkmale und Pläne ändern sich; überprüfen Sie sie mit einer repräsentativen Studie.
Kurzliste nach Betriebsbedarf
| Notwendigkeit | Auswertungswerkzeuge | Warum sie auf die Shortlist gelangen |
|---|---|---|
| Offene Telemetrie und lokale Inspektion | OpenTelemetry plus Arize Phoenix | Offene Instrumente und eine Möglichkeit zur Inspektion von Spuren und Bewertungen |
| LangChain- oder LangGraph-Entwicklung | LangSmith | Strenge Verfolgung, Datensatz und Evaluierungs-Workflow für dieses Ökosystem |
| Evaluierungs-Erstprodukt-Iteration | Gehirnvertrauen | Experimente, Scorer, Datensätze und Produktionsprotokolle in einer Schleife |
| Bestehende Unternehmensüberwachung | Datadog LLM Beobachtbarkeit | Agentsignale neben Anwendungsinfrastruktur und Vorfällen |
| Anbieter-neutrale Datenleitung | OpenTelemetry-Sammler plus gewählte Backend | Portable Veranstaltungskonventionen und Steuerung des Routings |
Dies ist eine Shortlist nach Fit, nicht ein universelles Ranking. Fügen Sie Sicherheits-, Datenresidenz-, Aufbewahrungs-, Einsatz- und Preisvoraussetzungen hinzu, bevor Sie ein Produkt auswählen.
Sieben Fähigkeiten zum Testen
1. End-to-end-Spuren
Die Spur sollte Modellanrufe, Abrufe, Werkzeugnutzung, Subbagenten, Wiederversuche und Genehmigungsschritte miteinander verbinden. Überprüfen Sie, ob asynchrone Arbeiten und Handsendungen weiterhin Teil des gleichen Laufs sind.
2. Versionerte Experimente
Vergleichen Sie die Änderungen von prompt, model, tool und retrieval auf demselben datensatz. Ein Diagramm ohne Versionmetadaten kann eine Regression nicht erklären.
3. Online- und Offline-Evaluierung
Suchen Sie nach deterministischen Prüfungen, modellbasierten Bewertungen, menschlichen Überprüfungen und maßgeschneiderten Geschäftsergebnissen. Bestätigen Sie, dass Sie einzelne Fehler hinter einem Gesamtwert überprüfen können.
4. Das ist nicht möglich. Kosten- und Latenzzuordnung
Das Produkt sollte Token, Kosten und Zeit den Schritten und Werkzeugen zugeschrieben werden, nicht nur der endgültigen Anfrage. Andernfalls kann sich eine erneute Versuchsschleife innerhalb eines akzeptablen Durchschnitts verstecken.
5. Datenschutzkontrollen
Test-Redaktion vor der Ausfuhr, rollenbasierter Zugriff, inhaltsfreie Tracing, Aufbewahrungskontrollen und Prüfprotokolle. Fragen Sie, ob Anfragen und Ausgänge für die Ausbildung von Verkäufern verwendet werden.
6. Das ist nicht wahr. Öffener Ausfuhr
Bestätigen Sie, dass Sie die Telemetrie mit einem dokumentierten Format senden oder exportieren können. Die Kompatibilität mit OpenTelemetry reduziert die Kosten für den Wechsel von Backends und die Verbindung von Agentenspuren mit der Überwachung von Anwendungen.
Sieben. Betriebsarbeitsfluss
Der nützliche Endpunkt ist eine Behebung: Warnung, Inspektion, Etikettierung, Hinzufügen eines fehlerhaften Falles zu einem Datensatz, Prüfung einer Änderung und Überprüfung des Produktionsergebnisses. Stellen Sie sicher, dass das Werkzeug diese Schleife ohne Archäologie unterstützt.
Verständnis der Produktkategorien
Öffnete Instrumentierungsstandards
OpenTelemetry ist nicht ein fertiger Beobachtbarkeitsprodukt an sich. Es bietet APIs, SDKs, Sammler und semantische Konventionen, die Anwendungen helfen, Telemetrie konsequent zu beschreiben und zu verweisen. Es gehört in die Kurzliste, wenn es um Portabilität, bestehende Überwachungsinfrastruktur oder Kontrolle über die Datenrouting geht.
Prüfen Sie die Reife der verwendeten Sprache, Modellprovider und Agent-Framework-Instrumente. Die Kompatibilität auf einer Verkäuferseite beweist nicht, dass Tool-Anrufe, Streaming, Abrufe, Handoffs und Fehler mit den Feldern angezeigt werden, die Ihr Team benötigt.
Agententwicklungsplattformen
Plattformen wie LangSmith verbinden Spuren mit prompt- oder workflow-Entwicklung, Datensätzen, Experimenten, Evaluatoren und Anmerkungen. Sie können den Abstand von einem fehlgeschlagenen Produktionslauf bis zu einem Regressionstest verkürzen, insbesondere wenn das Team bereits verwandte Rahmenbedingungen verwendet.
Die Bewertung sollte weiterhin eine Rahmenneutrale Anwendung umfassen. Bestätigen Sie, was durch native Integration funktioniert, was manuelle Instrumentation erfordert und wie Daten exportiert werden können.
Evaluierungsplattformen
Produkte wie Braintrust betonen Datensätze, Scorer, Experimente, Logs und Vergleiche. Sie passen in Teams, die die Bewertung als den Release-Vertrag behandeln, anstatt ein gelegentliches Dashboard.
Test komplexe mehrstufige Spuren, menschliche Anmerkungen, Produktionsprobenahme und der Weg von einer Berichtigung durch den Prüfer zu einem dauerhaften Testfall. Fragen Sie, wie die Veröffentlichung von Evaluator-Versionen und Änderungen des Richtermodells historische Vergleiche beeinflussen.
Inspektion und Experimentierung mit offenem Quell
Projekte wie Arize Phoenix können lokale oder selbstverwaltete Spureninspektionen und -bewertungen unterstützen. Open-Source gibt Teams Einsatz- und Anpassungsmöglichkeiten, aber sie besitzen Upgrades, Speicherung, Authentifizierung, Backup, Verfügbarkeit und Incident-Reaktion, es sei denn, ein verwalteter Service deckt sie ab.
Führen Sie die gleiche Sicherheitsüberprüfung durch, die Sie für einen kommerziellen Dienst bewerben würden. Selbstverwaltung verändert Verantwortung; sie entfernt sie nicht.
Überwachung der Unternehmensanwendungen
Plattformen wie Datadog verbinden KI-Signale mit Anwendungsspuren, Infrastruktur, Logs, Servicebesitz und On-Call-Workflows. Dies kann entscheidend sein, wenn ein Agentversagen Modellanrufe, API, Datenbanken, Warteschlangen und Netzwerkabhängigkeiten überschreitet.
Überprüfen Sie die Tiefe der agentenspezifischen Evaluierungs- und Datensatz-Workflows. Eine starke Infrastrukturkorrelation bietet nicht automatisch die redaktionelle oder domänenqualitative Schleife, die ein Produktteam benötigt.
Passt das Werkzeug zum Team
| Teamsituation | Beginnen Sie mit: | Validieren Sie vor der Verpflichtung |
|---|---|---|
| Ein kleines Team, ein Prototyp eines Agenten. | Native Tracing oder leichtes offenes Werkzeug | Debuggeschwindigkeit und minimale Aufstellungsüberschüsse |
| Produktteamsversand wöchentlich | Nachverfolgung plus veränderte Experimente und Datensätze | Regressionsarbeitsfluss und Kennzeichnung von Prüfern |
| Mehrfache Rahmenbedingungen und Anbieter | OpenTelemetrie-kompatible Instrumente | Konsistente Felder und Backend-Portabilität |
| Regulierte oder empfindliche Arbeitsbelastungen | Selbstverwaltete oder stark kontrollierte Dienstleistungen | Erstellung, Aufenthalt, Zugang, Aufbewahrung, Prüfung |
| Bestehendes Programm zur Beobachtbarkeit von Unternehmen | Aktuelle APM- und Agentenspezifische Erweiterung | Qualitätsbewertungstiefe und Spurenkorrelation |
| Forschungs- oder Bewertungsgruppe | Bewertungsplattform als erste | Reproduzierbarkeit, benutzerdefinierte Scorer, Datensatz-Governance |
Vermeiden Sie, die Größe der Organisation als einziges Signal zu betrachten. Ein kleiner gesetzlicher Workflow kann strengere Erfassungskontrollen benötigen als eine voluminöse öffentliche Demo, während ein großer interner Prototyp wenig Produktionsinfrastruktur benötigt.
Fünf Auswahlszenarien
Szenario 1: Ein Unterstützungsagent gibt eine falsche politische Antwort
Priorisieren Sie Multi-Turn-Threads, Abrufsspuren, Dokument-Version-Metadaten, Zitat-Evaluierung, Anmerkung und einen schnellen Weg von einer Benutzerkorrektur zu einem Regressionsfall. Die Infrastrukturstatistiken allein zeigen nicht, warum die veraltete Politik gewonnen hat.
Szenario 2: Ein Coding-Agent verbraucht unvorhersehbare Zeit und Token
Priorisieren Sie die verknüpften Werkzeug- und Modellspannen, die Sichtbarkeit von erneuten Versuchen und Schleife, Token- und Kostenzuweisungen, Sandbox-Ereignisse und den Vergleichen der Strecken zwischen den Versionen. Testen Sie einen Lauf, der nach dem Austausch von Dateien ausgeht, nicht nur einen erfolgreichen Code-Vorschlag.
Szenario 3: Ein regulierter Dokument-Arbeitsfluss
Priorisieren Sie inhaltlose Tracing, Redaktion vor Export, selbstverwaltete oder regionabhängige Speicherung, rollenbasierten Zugriff, Audit-Logs, Aufbewahrung und deterministische Validierungen. Ein kostengünstiges Instrument ist nicht geeignet, wenn die Prüfer nicht beweisen können, welche Quelle und welche Version das Ergebnis bestimmt hat.
Szenario 4: Ein Produktteam vergleicht wöchentlich Hinweise und Modelle
Priorisieren Sie Datensätze, Experimente, Evaluator-Versionisierung, Seite an Seite-Output-Review, statistische Zusammenfassungen und Produktionsfeedback. Das Team benötigt mehr Reproduzierbarkeit und Veränderungsvergleich als eine reife On-Call-Schnittstelle.
Szenario 5: Viele Teams verwenden verschiedene Agenten-Rahmen
Priorisieren Sie die OpenTelemetry-Kompatibilität, ein gemeinsames Ereignisschema, die Sammlersteuerung, die Rahmen-neutrale Verfolgung und den Export. Test semantische Konsistenz über zwei Rahmenbedingungen hinweg; die bloße Akzeptanz von OTLP garantiert keine vergleichbaren Agentenspausen.
Verwenden Sie eine gewichtete Entscheidungsmatrix
Stellen Sie Gewichte vor den Prüfungen fest. Das folgende Beispiel eignet sich für einen Produktionskenntnis-Arbeitsmittel; adaptieren Sie ihn an das tatsächliche Risiko.
| Kriterium | Gewicht | Kandidat A | Kandidat B | Kandidat C |
|---|---|---|---|---|
| Spurenvollständigkeit | 20 | |||
| Bewertungsarbeitsfluss | ||||
| Privatsphäre und Zugang | 20 | |||
| Debug und Überprüfung der Benutzerfreundlichkeit | ||||
| Integration und Portabilität | 10 | |||
| Produktionsabläufe | 10 | |||
| Gesamtkosten | 10 |
Bezahlen Sie jeweils von 0 bis 5 mit Beweisen aus dem Konzeptnachweis. Hinzufügen einer separaten Pass-/Fail-Liste für nicht verhandelbare Anforderungen wie Region, Löschung, SSO oder Unterdrückung von Inhalten. Eine hohe gewichtete Punktzahl darf eine gescheiterte gesetzliche oder Sicherheitsanforderung nicht übersteigen.
Erfordern Sie eine Note und testen Sie hinter jeder Punktzahl. Andernfalls verwandelt die Matrix Demo-Eindrücke in Dezimalzahlen.
Benutzerfreundlichkeit des Testreviewers
Beobachtbarkeit dient mehr als Ingenieuren. Bitten Sie einen Produktmanager, Domainspezialisten, Sicherheitsprüfer und Supportbetreiber, die gleichen markierten Laufen ohne Coaching zu untersuchen.
Beobachten Sie, ob sie:
- die Ausführung aus einem Benutzerbericht oder einem Artefakt-ID zu finden;
- die Sequenz verstehen, ohne Roh-JSON zu lesen;
- öffnen Sie das exakte Ergebnis der abgerufenen Quelle und des Werkzeugs;
- Unterscheidung zwischen Produktionsinput und Bewertungskommentaren;
- die Ausfälle zu kennzeichnen und einen Eigentümer zu vergeben;
- Vergleichen Sie die fehlerhafte Version mit einer Kandidaten-Fixung;
- die Beweise für einen Vorfall oder eine Prüfung ausführen;
- Vermeiden Sie, Inhalte außerhalb Ihrer Genehmigung zu sehen.
Aufzeichnen Sie die Fertigstellungszeit und Fehler. Eine Plattform, die für ihren Implementierer mächtig ist, aber für die Kritiker, die Qualität beurteilen, unbrauchbar ist, wird die Verbesserungsschleife unvollständig lassen.
Bewertung der Warnung und der Reaktion auf Vorfälle
Erstellen Sie drei Testvorfälle: Ein Ausfall des Werkzeugs, eine plötzliche Kostenehöhung und eine Rückkehr in die Ausgabequalität. Bestätigen Sie, wie die betroffenen Plattformgruppen Laufungen, Doppelkopien entfernen, Änderungen an Verknüpfungen vornehmen, Benachrichtigungen durchführen und Beweise speichern.
Qualitätswarnungen benötigen ausreichend Lautstärke und Kalibrierung, um Lärm zu vermeiden. Ein einziger niedriger Stichprobenwert kann einen Überprüfungsbetrag erzeugen; ein anhaltender Rückgang der akzeptierten Ausführung kann einen Vorfall rechtfertigen. Sicherheits- und Datenschutzereignisse können eine sofortige Reaktion von einem bestätigten Fall erfordern.
Überprüfen Sie, ob die Benachrichtigungen nicht nur technische Telemetrie, sondern auch Geschäftsergebnisse wie abgelehnte Lieferungen oder ungelöste Unterstützungsfälle verwenden können. Der wichtigste Produktionsfehler kann HTTP 200 zurückgeben.
Planung der Instrumentarchitektur
Bewerbung durch Agenten
-> Instrumentierung und Redaktion im Prozess
-> OpenTelemetry oder Anbieter SDK
-> kontrollierter Sammler oder Gateway
-> Routing- und Probenahmepolitik
-> Beobachtbarkeits-Backend
-> Bewertung und Anmerkung
-> Zwischenfälle, Probleme und Einsatzsysteme
Das geheime Filtern und die obligatorische Klassifizierung sind so nah wie möglich an die Anwendung angebracht. Verwenden Sie einen Sammler oder ein Gateway, um die Routing-, Probenahme-, Anreicherung- und Bestimmungssteuerung konsequent anzuwenden. Halten Sie den Workflow und die Freisetzung von Metadaten mit den Bereitstellungsunterlagen verbunden, damit eine Änderung untersucht werden kann.
Dokumentenversagen Verhalten. Wenn das beobachtbare Backend nicht verfügbar ist, entscheiden Sie, ob die Telemetrie den Workflow buftet, abnimmt oder blockiert. Die meisten Benutzervermittler sollten nicht nur deshalb versagen, weil die optionale Nachverfolgung abgeschwächt ist, aber Hochrisiko-Arbeitsflüsse können eine dauerhafte Prüfung vor Beginn einer nachfolgenden Maßnahme erfordern.
Vermeiden Sie Benchmark-Faschen
Verkäufervergleiche zählen häufig Integrationen oder präsentieren synthetische Latenz. Diese Signale zeigen nicht, ob Ihr Team seine Fehler lösen kann. Verwenden Sie die gleiche Agentversion, Testfälle, Probenahme, Inhaltsfangmodus, Aufbewahrung und Evaluator-Definitionen für jeden Kandidaten.
Vergleichen Sie kein lokal gehostetes Open-Source-Tool mit einem Managed-Service, wobei interne Infrastruktur und Arbeitskräfte ausgeschlossen sind. Vergleichen Sie den Preis nicht, wenn die Kandidaten Spans, Token, Lagerung, Bewertungen und Sitzplätze anders zählen. Normalisieren Sie die Kosten pro akzeptierten Workflow-Ergebnis unter den gleichen Volumen-Annahmen.
Bewahren Sie die ursprünglichen Rohtest-Ausgänge und die Punktzahlnoten. Wenn sich ein Kandidat während des Tests verbessert, erfassen Sie die Version und laufen Sie den festen Test erneut aus, anstatt die alte Punktzahl aus dem Gedächtnis zu bearbeiten.
Schreiben Sie Anforderungen von Fehlern
Verwandeln Sie Beton-Debugging-Geschichten in Akzeptanzstests:
Fehlschlag: Der Agent zitierte eine veraltete Richtlinie nach einem dreifachen Gespräch.
Erforderliche Beweise:
- Vollständige Gesprächs- und Ausführungs-Identifikationen
- Abruffragen und zurückgegebene Dokumentversionen
- Versionen von Prompt, Modell und Workflow
- Werkzeug- und Rückfallsequenz
- Ergebnis der Zitierungsbewertung
- Endnutzerkorrektur und Ergebnis

Akzeptanzprüfung:
Ein Reviewer kann die veraltete Abrufung finden, den Lauf zu einem Datensatz hinzufügen,
Vergleichen Sie eine vorgeschlagene Regelung und bestätigen Sie die korrigierte Produktionsversion.
Erstellen Sie mindestens fünf Geschichten: falsche Antwort, teure Schleife, langsame Abhängigkeit, Erlaubnisversagen und vertrauliche Spuren. Eine Verkäuferdemonstration sollte diese Geschichten mit Ihrer Datenform reproduzieren, anstatt ein vorbereitetes Dashboard zu präsentieren.
Eine zweitägige Konzeptnachweis-Scorecard
Testen Sie zwei wirkliche Arbeitsabläufe und bewerten Sie jedes Kriterium von 0 bis 2.
| Kriterium | 0 | 1 | 2 |
|---|---|---|---|
| Spurenvollständigkeit | Wichtige Schritte fehlen | Die meisten Schritte sichtbar | Volllauf ist wiederherstellbar |
| Bewertungsgemäß | Feste generische Punkte | Ein gewisser benutzerdefinierter Logik . | Aufgabenspezifische und verarbeitete Versionen |
| Debug-Zeit | Keine Verbesserung | Teilweise Verbesserung | Die Ursache wurde schnell gefunden. |
| Privatsphäre | Inhalte, die immer gespeichert werden | Manuelle Steuerungen | Politikgestützte Minimierung |
| Übertragbarkeit | Schlossene Ausfuhren | Teilweise Ausfuhr | Öffener, dokumentierter Export |
| Ergebnisverbindung | Keine Benutzerergebnisse | Manuelle Etiketten | Das Ergebnis schließt sich zu jedem Lauf |
Arbeitsabläufe:
Nicht reproduzierbar:
Erforderliche Spurenfelder:
Empfindliche Felder zu unterdrücken:
Offline-Evaluierungssatz:
Produktionsergebnis:
Warnungsschwelle:
Der Kritiker:
Ausgangsentscheidung: Annahme / Verlängerung des Tests / Ablehnung
Ein täglicher Beweis des Konzepts
Tag 1-2: Einfrieren Sie den Test
Wählen Sie zwei Arbeitsabläufe, zehn bekannte Ausfälle, zehn Fehler und einen empfindlichen Fall. Dokument der aktuellen Debug-Zeit, Kosten, Latenzzeit und Akzeptanzrate. Abschließen Sie die Punktzahl Rubrik, bevor die Anbieter das Produkt konfigurieren.
Tage 3-4: Instrument
Verbinden Sie den Workflow. Erfassen Sie die automatisch angezeigten Felder, die erforderlichen Codeänderungen, fehlende Zeiten und die Einstellzeit. Überprüfen Sie Streaming, Wiederversuche, Hintergrundarbeiten und Toolfehler, anstatt nach einem erfolgreichen Chat zu stoppen.
Tage 5-6: Beurteilung
Import oder Erstellung eines Datensatzes, Hinzufügen von deterministischen und qualitativen Evaluatoren und Vergleichen zweier kontrollierter Workflow-Versionen. Eine Domain-Review-Label-Fehler fehlschlägt, ohne sich auf die Standard-Score des Anbieters zu verlassen.
Tage 7-8: Testoperationen
Erstellen Sie eine Warnung, untersuchen Sie sie, geben Sie eine Korrektur, fügen Sie den Lauf zur Regression hinzu und überprüfen Sie eine feste Version. Exportverfolgungs- und Bewertungsdaten. Testrollenänderungen und Entfernung des Zugriffs eines Benutzers.
Tage 9-10: Test-Governance und Kosten
Ausüben Sie Redaktierung, Aufbewahrung, Löschung, Prüfprotokolle und Inhaltsfreie Erfassung. Schätzungsweise monatliche Einnahme, Lagerung, Auswertung, Sitzplätze, Unterstützung und technischen Betrieb. Aufzeichnung von Annahmen und Volumenbanden.
Endet mit einer schriftlichen Entscheidung. Ein ausgefeilter Konzeptnachweis kann immer noch fehlen, weil der Export unvollständig ist, die Prüfer ihn nicht verwenden können oder die prognostizierten Bewertungskosten zu hoch sind.
Schätzung der gesamten Eigentumskosten
Mehr als der Abonnementpreis:
| Kostenbereich | Fragen |
|---|---|
| Verzehrung | Werden Spans, Token, Ereignisse oder Bytes in Rechnung gestellt? Was wird geprobt? |
| Aufbewahrung | Wie beeinflussen heiße, archivierte und gelöschte Spuren die Kosten? |
| Auswertung | Sind Richter-Modell-Anrufe enthalten oder durchlaufen? |
| Sitzplätze | Welche Ingenieure, Rezensenten, Auditoren und Zuschauer brauchen Zugang? |
| Gastgeber | Für selbstverwaltete Werkzeuge, wer besitzt Rechner, Speicher, Backup und Upgrades? |
| Technik | Wie viel maßgeschneiderte Instrumente und Wartung benötigt man? |
| Einwanderung | Können historische Spuren, Datensätze, Etiketten und Evaluatoren exportiert werden? |
| Reaktion auf Vorfälle | Stimmt die Förderdeckung mit dem Produktionsrisiko und den Zeitzonen überein? |
Modell drei Bände: aktuelle, erwartete zwölfmonatige Nutzung und ein Spike. Die Probenahme und die Aufbewahrung sollten in jedem Modell explizit sein. Billige Einnahme kann teuer werden, wenn sich die vollständigen Anfragen, Ausgänge und Beurteilungsbeurteilungen bei jedem Lauf vervielfachen.
Sicherheits- und Datenschutzüberprüfung
Bitte den Anbieter, zu zeigen, nicht nur zu beschreiben:
- die Bearbeitung vor der Veröffentlichung der Daten;
- nur mit Metadaten durch Arbeitsflussklassifizierung zu verfolgen;
- Verschlüsselung im Transit und im Ruheverkehr;
- regionale Verarbeitungs- und Lagerauswahlmöglichkeiten;
- die Isolation der Mieter und der rollenbasierte Zugang;
- Prüfprotokolle für die Anzeige und den Export;
- konfigurierbare Aufbewahrung und verifizierte Löschung;
- die Bearbeitung von Anfragen, Ausgängen und Telemetrie für Modellschulungen;
- Subprozessoren und Support-Zugriff;
- Geheime Erkennung in Werkzeugargumenten und Fehlermeldungen.
Erstellen Sie einen Test-Trace mit synthetischen Anmeldeinformationen und personenbezogenen Daten und bestätigen Sie dann den erwarteten Block oder die Redaktion an jedem Bestimmungsort. Verwenden Sie niemals wahre Geheimnisse für diesen Test.
Bauen, kaufen oder kombinieren
Kaufen Sie eine verwaltete PlattformWenn Geschwindigkeit, Zusammenarbeit, gehostete Bewertung und Support wichtiger sind als die maximale Infrastrukturkontrolle.
Selbstverwaltung eines Open-Source-Stackswenn die Datenkontrolle, die Anpassung oder die Integration mit der internen Infrastruktur eine laufende Betriebsbesitzberechtigung rechtfertigt.
Erweiterung der bestehenden APMwenn Zwischenservice-Inzidenzen und etablierte Call-On-Call-Praktiken vorherrschen, sofern eine Bewertung der Qualität des Agenten hinzugefügt werden kann.
Kombinieren Sie offene Instrumentation mit einem gewählten Backendwenn Portabilität erforderlich ist. Dies ist oft ein praktischer Mittelweg, aber nur, wenn das gemeinsame Schema die Details behält, die das Backend benötigt.
Vermeiden Sie, eine komplette Schnittstelle zu bauen, nur um eine Lizenz zu vermeiden. Eine individuelle Instrumentation und ein kleiner interner Qualitätsbericht können angemessen sein; die Wiederherstellung von Spurensuchen, Bewertung, Anmerkung, Zugriffskontrolle und Aufbewahrung ist ein Produktverpflichtung.
Checkliste für Migration und Ausreise
[ ] Spuren- und Exportdaten in dokumentiertem, nutzbarem Format.
[ ] Datensätze speichern Eingaben, erwartete Ausgänge, Metadaten und Splits.
[ ] menschliche Etiketten und die Identität der Prüfer können unter der Richtlinie aufbewahrt werden.
[ ] Definitionen und Versionen von Evaluatoren können an anderer Stelle neu erstellt werden.
[ ] Verweise auf die Version von Prompts und Workflow bleiben sinnvoll.
[ ] Warnungen, Dashboards und gespeicherte Abfragen werden in Inventarierung aufgenommen.
[ ] Die Entfernung des SDK verletzt den Produktionsworkflow nicht.
[ ] Die Löschung aus dem früheren Dienst kann überprüft werden.
Führen Sie während des Prozesses einen Export aus. Die Vertragssprache ersetzt nicht die Frage, ob die ergebenden Daten eine nützliche Untersuchung wieder aufbauen können.
Annahme nach dem Kauf
Beginnen Sie mit der gemeinsamen Benennung, den erforderlichen Attributen, den Abfangsmodus und den Workflow-Ergebnisfeldern. Veröffentlichen Sie ein Instrumentationsbeispiel und überprüfen Sie es wie einen API-Vertrag. Wenn jedes Team seine eigene erfindet .agent_nameIn der Regel ist es nicht möglich, eine vergleichbare Sichtweise zu erstellen.
Erstellen Sie Eigentümer für Instrumentation, Plattformbetrieb, Bewertung, Domain-Review, Privatsphäre und Incident-Reaktion. Eine monatliche Fehlerüberprüfung durchzuführen, bei der eine kleine Anzahl von Änderungen ausgewählt und deren Produktionswirkung überprüft wird. Mehr Spuren ohne Betriebskadenz schaffen Speicher, nicht Zuverlässigkeit.
Audit speicherte Dashboards und Warnungen nach jeder wichtigen Workflow-Änderung. Entfernen Sie Metriken, die nicht mehr zu einer Entscheidung führen, und prüfen Sie, ob neue Werkzeuge oder Handoffs vor dem Einsatz in Spuren erscheinen.
Fragen für eine Anfrage oder einen Anruf an den Anbieter
- Welche Agenten-Rahmen, Modellanbieter und Sprachen werden auf Stufenebene unterstützt?
- Wie werden mehrfach drehende Fäden, Subbagenten, asynchrone Arbeiten und Handsendungen dargestellt?
- Welche OpenTelemetry-Konventionen und Exportwege werden heute unterstützt?
- Können wir benutzerdefinierte, modellbasierte und menschliche Bewertungen durchführen?
- Wie sind Datensätze, Evaluatoren, Anfragen und Workflow-Versionen miteinander verbunden?
- Wo findet die Redaktion statt und kann die Inhaltsfassung durch die Richtlinie deaktiviert werden?
- Was sind die Ausfallzeiten und die Höchstdauer der Aufbewahrung?
- Wie wird der Zugang, die Betreuung und die Exporte geprüft?
- Was geschieht mit unseren Daten während des Modelltrainings und der Serviceverbesserung?
- Wie beeinflussen sich die Preise durch Räume, Lagerung, Bewertungen und Sitzplätze?
- Was können wir ausführen, wenn wir gehen, und in welchem Format?
- Welche derzeitigen Einschränkungen würden unsere Versagen beim Beweis von Konzepten beeinflussen?
Häufige Auswahlfehler
- Kaufen Sie für attraktive Dashboards, bevor Sie eine Debug-Frage definieren.
- Eine allgemeine Stimmung oder Relevanz als Beweis für den Erfolg der Aufgabe zu behandeln.
- Vollständige Inhalte nach Standard zu erfassen und später Privatsphäre zu gestalten.
- Vergleichen Sie Werkzeuge mit Spielzeug-Chat-Anfragen anstelle von mehrfachen Fehlern.
- Die Anlage auf ein Backend zu sperren, ohne den Export zu testen.
- Erfolg der Anfrage zu messen und gleichzeitig zu ignorieren, ob die Benutzer die Arbeit akzeptieren.
Ein weiterer häufiger Fehler besteht darin, aus einer Vergleichstabelle zu wählen, ohne das Veröffentlichungsdatum zu bestätigen. Die Produkte zur Beobachtung von Agenten entwickeln sich schnell. Diese Leitfaden sollten als Anforderungenrahmen behandelt werden und dann alle Fähigkeiten in der aktuellen Dokumentation und in der Prüfumgebung überprüft werden.
Der Begleiter .KI-Agent-Überwachungs-Leitfaden definiert das Ereignis- und Überprüfungsmodell. Die Agentische Arbeitsabläufe-Erläuterung Es wird dabei unterstützt, zu erkennen, welche Schritte und menschliche Entscheidungen in eine Spur gehören.
FAQ
Sind LLM-Überwachbarkeit und KI-Agenten-Überwachbarkeit gleich?
Sie überlappen sich, aber die Beobachtbarkeit von Agenten umfasst mehr als nur Modellanrufe. Es muss Planung, Abholung, Werkzeuge, Zustand, Übergabe, erneute Versuche, Berechtigungen, Genehmigungen und endgültige Ergebnisse umfassen.
Ist ein Open-Source-Tool immer billiger?
Nein. Die Lizenzkosten sind nur eine Komponente. Umfassen Sie Hosting, Speicherung, Wartung, Zugriffssteuerung, Integration bei Aufruf und die für die Aktualisierung der Instrumente erforderliche technische Zeit.
Kann Standard-Anwendungsüberwachung mit Agenten umgehen?
Es kann die Gesundheit von Infrastrukturen und Dienstleistungen abdecken. Es benötigt in der Regel agent-spezifische Spuren und Bewertungen, um Verhaltensfehler und Aufgabenqualität zu erklären.
Wie viele Werkzeuge sollten wir ausprobieren?
Zwei oder drei reichen aus, wenn die Punktzahl und die repräsentativen Fehler im Voraus behoben werden. Eine breite Tour erzeugt Screenshots, nicht eine Entscheidung.
Brauchen wir sowohl Nachverfolgung als auch Bewertung?
Ja, für die meisten Produktionsvertreter. Das Tracing erklärt die Sequenz; die Bewertung beurteilt, ob das Ergebnis und das Verhalten dem Aufgabenvertrag entsprechen. Jeder einzelne hinterlässt eine wichtige Lücke.
Sollten die Beobachtungsdaten in derselben Region wie die Produktionsdaten verbleiben?
Das hängt von der geltenden Politik, den Verträgen und der Einstufung der Daten ab. Telemetrie als möglicherweise sensible Produktionsdaten zu behandeln und die Anforderungen an Verarbeitung, Speicherung, Zugang und Übertragung zu überprüfen.
Was sollten wir während eines Prozesses exportieren?
Exporte repräsentative Spuren, Datensätze, menschliche Etiketten, Bewertungsergebnisse und Konfigurationsdefinitionen. Bestätigen Sie, dass ein anderer Ingenieur sie ohne die ursprüngliche Schnittstelle verstehen und wiederverwenden kann.
Welches KI-Observierungswerkzeug ist das beste für ein Startup?
Es gibt keinen automatischen Startup-Gewinner. Beginnen Sie mit der leichtesten Option, die den echten Workflow rekonstruiert und eine Versagen-to-Test-Schleife unterstützt. Vermeiden Sie eine Unternehmensplattform, deren Betrieb die Komplexität des Agenten übersteigt, aber bewahren Sie einen Exportweg.
Können wir später die Beobachtbarkeitsrückstände wechseln?
Die offene Instrumentation hilft, aber Dashboards, Evaluator-Definitionen, Anmerkungen, Datensätze, Warnungen und proprietäre Felder können immer noch ein Lock-in erstellen. Export- und Erholungstests während des Konzeptnachweises.
Sollte die Bewertung auf jeder Produktionsspuren durchgeführt werden?
Nicht unbedingt. Verwenden Sie deterministische Kontrollen allgemein, wenn sie kostengünstig sind, auf Stichprobenmodellen basieren und von Menschen nach Risiko und Volumen bewertet werden, und überprüfen Sie immer bestätigte Vorfälle mit hohem Einfluss im Rahmen der Politik.
Beginnen Sie die Bewertung mit einem realen Workflow in Ottermind und bewahren Sie das Quellenpaket, das akzeptierte Ergebnis und die Korrekturen der Prüfer als gemeinsamen Testfall auf.
