概念解析
什么是 AI Agent Memory?短期记忆、长期记忆与项目上下文
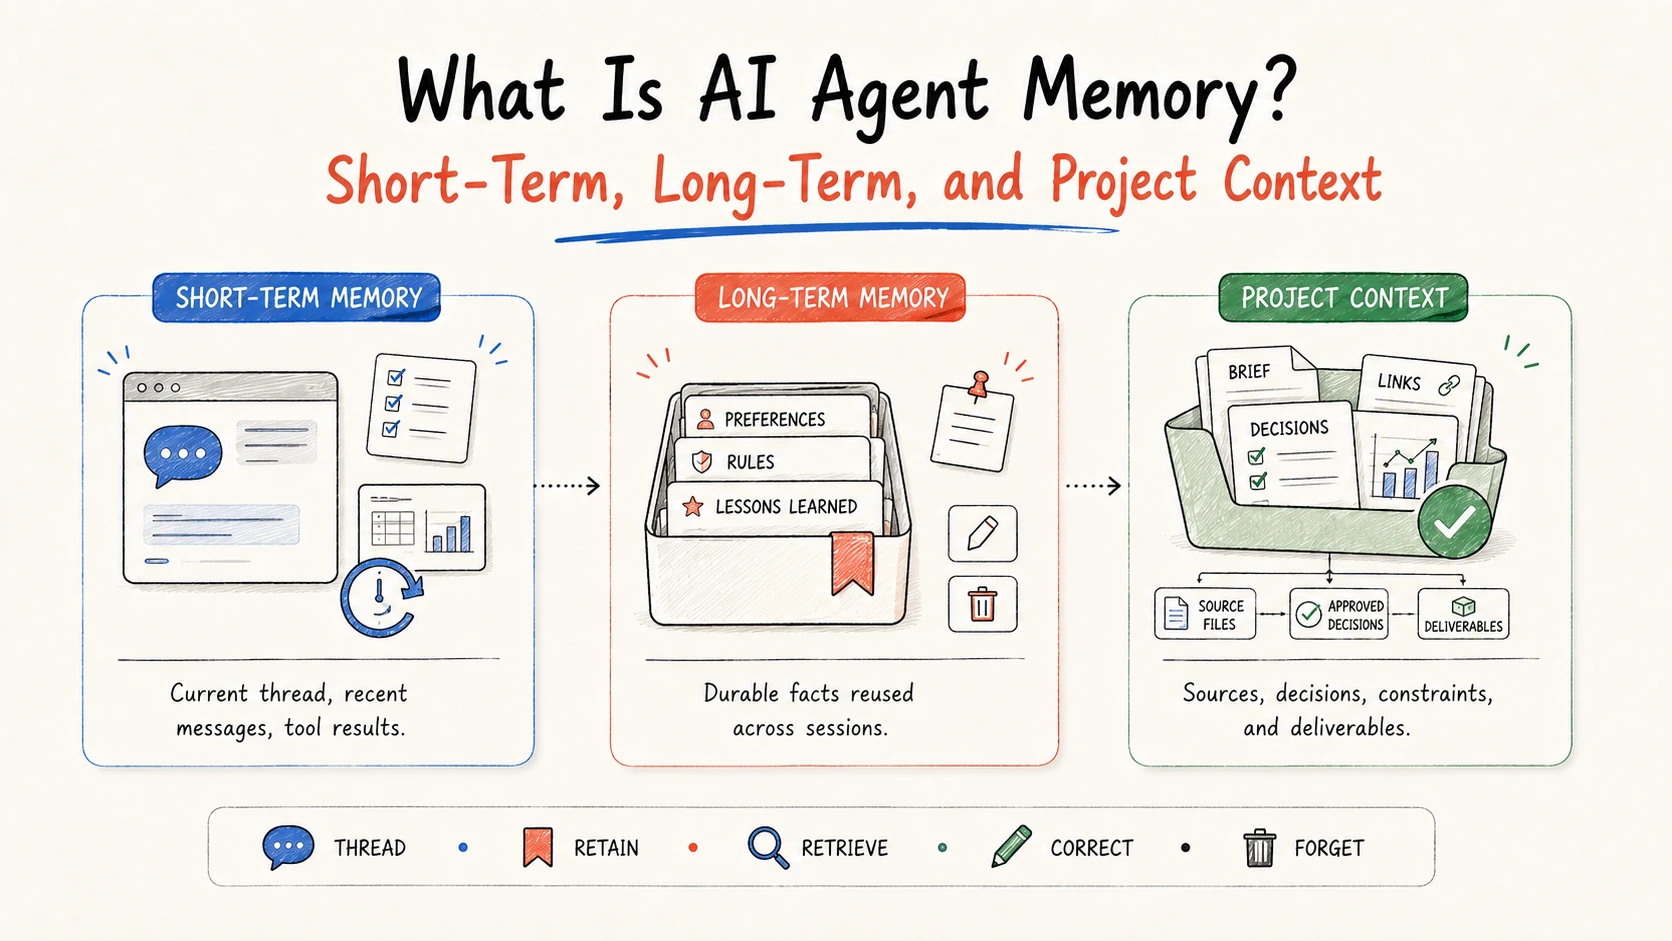
AI Agent Memory 是智能体能够带到后续任务中的信息,让它不必每次都从空白开始。短期记忆服务当前对话,长期记忆保存跨会话仍有价值的事实,项目上下文则把一个项目的文件、决定、限制和交付物连接起来。
研究与披露: 我们于 2026 年 8 月 27 日查阅了 OpenAI Agents SDK Memory、Sessions、Context 和 LangGraph Memory 文档。这些是实现参考,不是 Ottermind 基准测试。
三种记忆范围
| 范围 | 保存内容 | 适合场景 |
|---|---|---|
| 短期记忆 | 最近消息、工具结果和工作状态 | 继续当前线程、恢复中断任务 |
| 长期记忆 | 用户、团队或应用的稳定事实 | 偏好、重复规则和可复用经验 |
| 项目上下文 | 来源、决定、指令、产物和待解决问题 | 在相关交付物之间保持同一项目连贯 |
短期记忆:正在工作的线程
短期记忆是当前任务的工作区,包含对话、计划、工具响应和待办问题。它帮助 Agent 理解“修改第二个选项”这类指令,也支持暂停后恢复。但长线程应及时总结、裁剪重复内容,并标记失败尝试;旧信息不应自动被视为事实。
长期记忆:跨会话的稳定事实
长期记忆可以保存反复确认的格式偏好、团队规则或已验证的经验。每条候选记忆都要问:是否足够稳定?范围是用户、团队还是项目?负责人是否预期它会被保存?能否纠正或删除?是否包含敏感信息?不要把一次性请求变成永久偏好,也不要默认保存秘密或推测性结论。
项目上下文:有边界的记忆
项目上下文围绕一个结果组织来源文件、链接、已批准事实、决定、反馈、负责人和截止时间。它避免用户在报告变成演示文稿时重复 Brief,也避免某个项目的发布主张泄漏成全局用户偏好。每个事实都应显示来源、日期、负责人、状态和受影响的下游产物;来源变化时,要把下游工作标记为过期。
记忆不等于检索
保存信息和把它放入当前上下文是两件事。检索时检查范围、相关性、新鲜度、来源权威和冲突处理。当前用户指令与已批准的项目来源通常应优先于旧的推断偏好;影响结果的冲突应要求人确认。
如何设计记忆架构
一个知识工作 Agent 可以分为:线程状态、可编辑的工作摘要、带负责人和时间戳的长期事实、项目记录,以及访问、修改、删除和过期审计。会话存储不自动等于长期记忆,项目文件夹也不自动等于安全的个人档案。
常见失败
- 什么都记住: 成本、隐私风险和检索噪音一起上升。
- 范围错误: 项目指令变成全局偏好,或个人信息进入团队上下文。
- 旧事实胜出: 没有时间戳和优先级,过期信息覆盖当前要求。
- 无法检查: 用户看不到记忆来源,也无法修改或删除。
- 把记忆当真相: 记忆只是证据,重要事实仍需回到当前来源确认。
如何选择要记住的信息
把候选信息分成一次性内容、线程级信息、项目级信息、反复确认的持久偏好,以及敏感或不确定内容。后者默认不要保存。测试时修改一个项目事实,启动相关交付物,确认新事实生效且其他项目不受影响。
Ottermind 如何承接
Ottermind 是一个 AI Agent 工作空间,把目标、文件、链接、决定、中间工作和后续任务保持在所属项目附近。这是有边界的项目上下文,不代表每次对话都会变成永久个人记忆。请指定事实来源,先审核上下文,再要求高后果输出,并为过期信息保留纠正和删除路径。
常见问题
聊天记录等于 Agent Memory 吗?
不等于。聊天记录只是短期上下文的一种来源;Agent Memory 还包括跨会话事实、摘要、检查点和项目记录。
长期记忆与项目上下文有什么区别?
长期记忆保存跨会话仍有价值的事实;项目上下文围绕一个具体结果组织来源、决定、产物和依赖。
记忆越多,Agent 就越聪明吗?
不一定。更多数据可能带来成本和无关检索。好的记忆应有范围、时效、来源、可编辑性,并且与当前任务相关。
结论
短期记忆让任务继续,长期记忆保存谨慎选择的稳定事实,项目上下文让一项工作保持连贯。明确边界、显示来源,并把纠正和遗忘纳入设计。
